L’IA devient une infrastructure d’entreprise
· Par Antonio Sedino, CTRO · Reinventy Solutions Corp.
Dix Thor par module, une architecture évolutive et Tin Man OS pour gouverner modèles, ressources et continuité. Le projet Sovereign Edge AI place une question concrète au centre du débat : que faut-il pour que l’intelligence artificielle devienne une capacité que l’entreprise sait gérer ?
Au cœur du projet de micro centre de données souverain Reinventy
Une part croissante de la valeur d’une entreprise réside dans ses documents, ses procédures, son code et l’expérience de ses équipes. L’intelligence artificielle peut rendre ce patrimoine plus accessible : aider à lire un cahier des charges, rapprocher des informations dispersées, préparer une simulation ou accompagner un concepteur. Pour y parvenir, il faut donner à l’IA une place précise dans l’organisation : décider où elle travaille, avec quelles données, quels outils et sous quelle responsabilité.
Le projet Reinventy Sovereign Edge AI répond à ce besoin. Il propose un micro centre de données modulaire réunissant calcul, réseau, gestion, alimentation protégée et refroidissement, avec un logiciel conçu pour transformer des ressources physiques en services utilisables. L’objectif est de passer d’un accès occasionnel à la puissance de calcul à une capacité opérationnelle conçue comme un ensemble cohérent.
État du projet. Cet éditorial présente les spécifications matérielles SEA HW 001 et logicielles SEA SW 001, révision 1.0 du 20 octobre 2026. Elles définissent l’architecture, les opérations et les étapes de réalisation ; la nomenclature définitive, les plans de fabrication, les nouveaux composants logiciels et la qualification physique restent à achever. Les images illustrent le projet et n’attestent ni un système déjà construit ni des performances mesurées.
Un module complet, avec dix nœuds de calcul
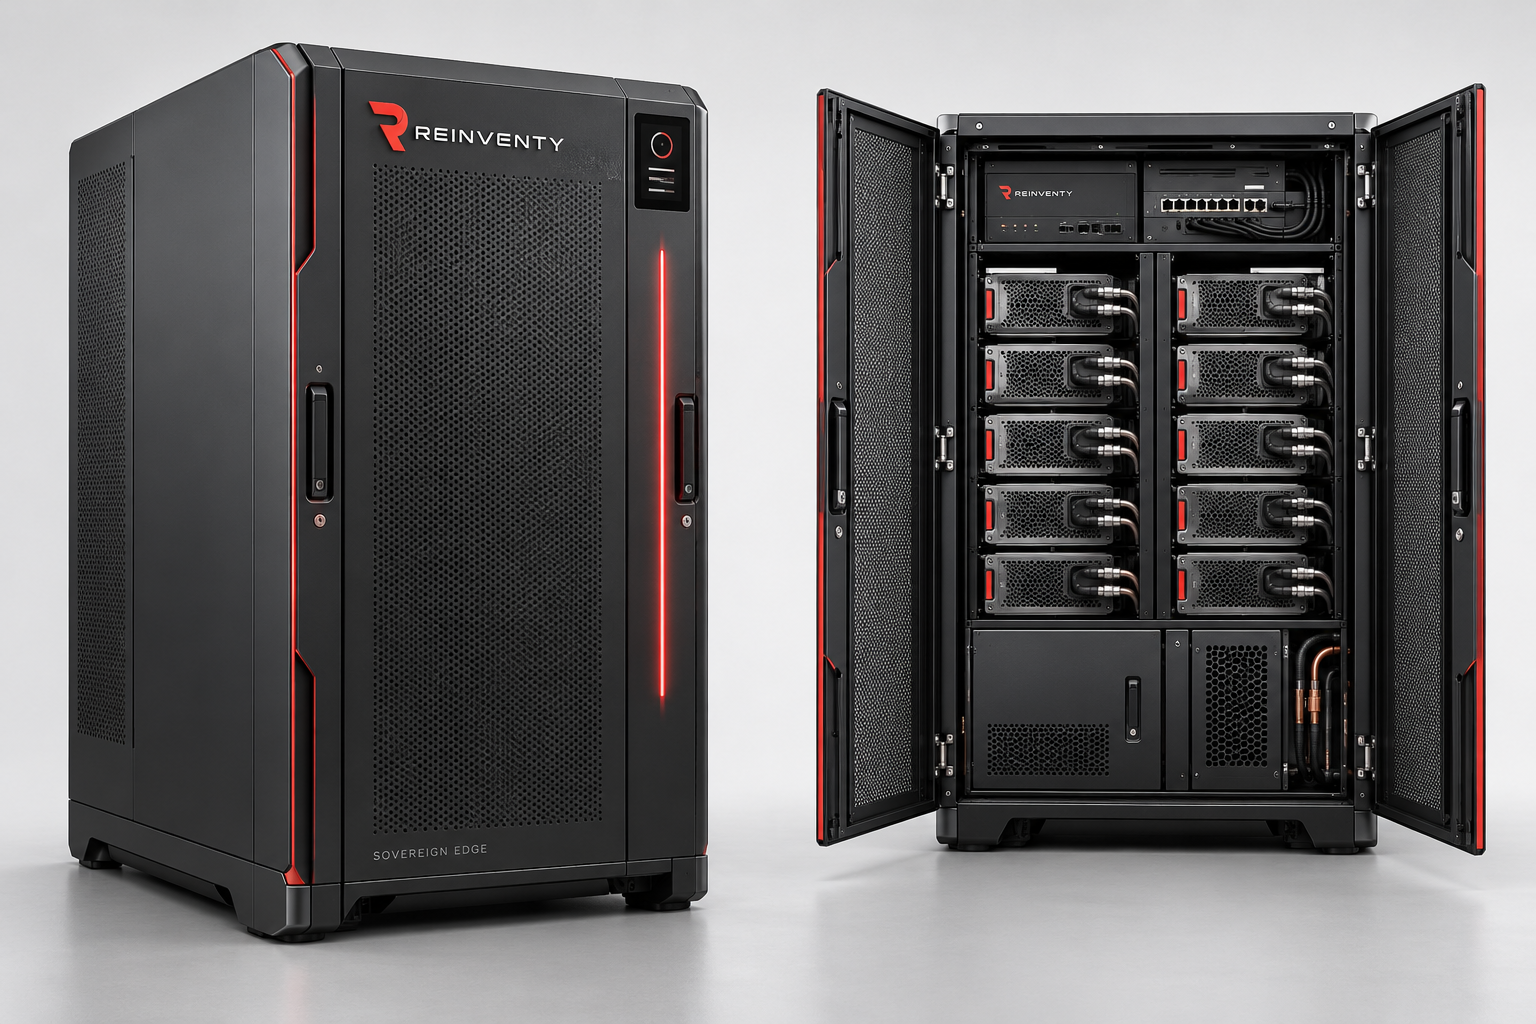
L’unité de référence prévoit dix NVIDIA Jetson T5000, appelés Thor, chacun disposant de 128 Go nominaux de mémoire unifiée et d’un SSD local de 8 To dans la configuration envisagée. Un PC intégré coordonne le module ; le réseau interne relie les nœuds ; refroidissement liquide, onduleur APC en ligne avec batteries et supervision physique indépendante complètent l’ensemble.
L’agencement proposé rend l’architecture lisible : contrôle et réseau en partie haute, dix tiroirs de calcul au centre, onduleur et batteries en partie basse, circuit thermique dans un compartiment technique dédié. Ce choix concerne aussi la maintenance : identifier un nœud, atteindre les connexions et remplacer une pièce doivent être des opérations préparées.
Le système est conçu pour évoluer d’un à quatre modules, soit de 10 à 40 Thor. Une DGX externe peut élargir les possibilités ou fournir une plateforme de comparaison ; le module de base doit pouvoir fonctionner localement sans elle et sans qu’un poste client reste connecté.
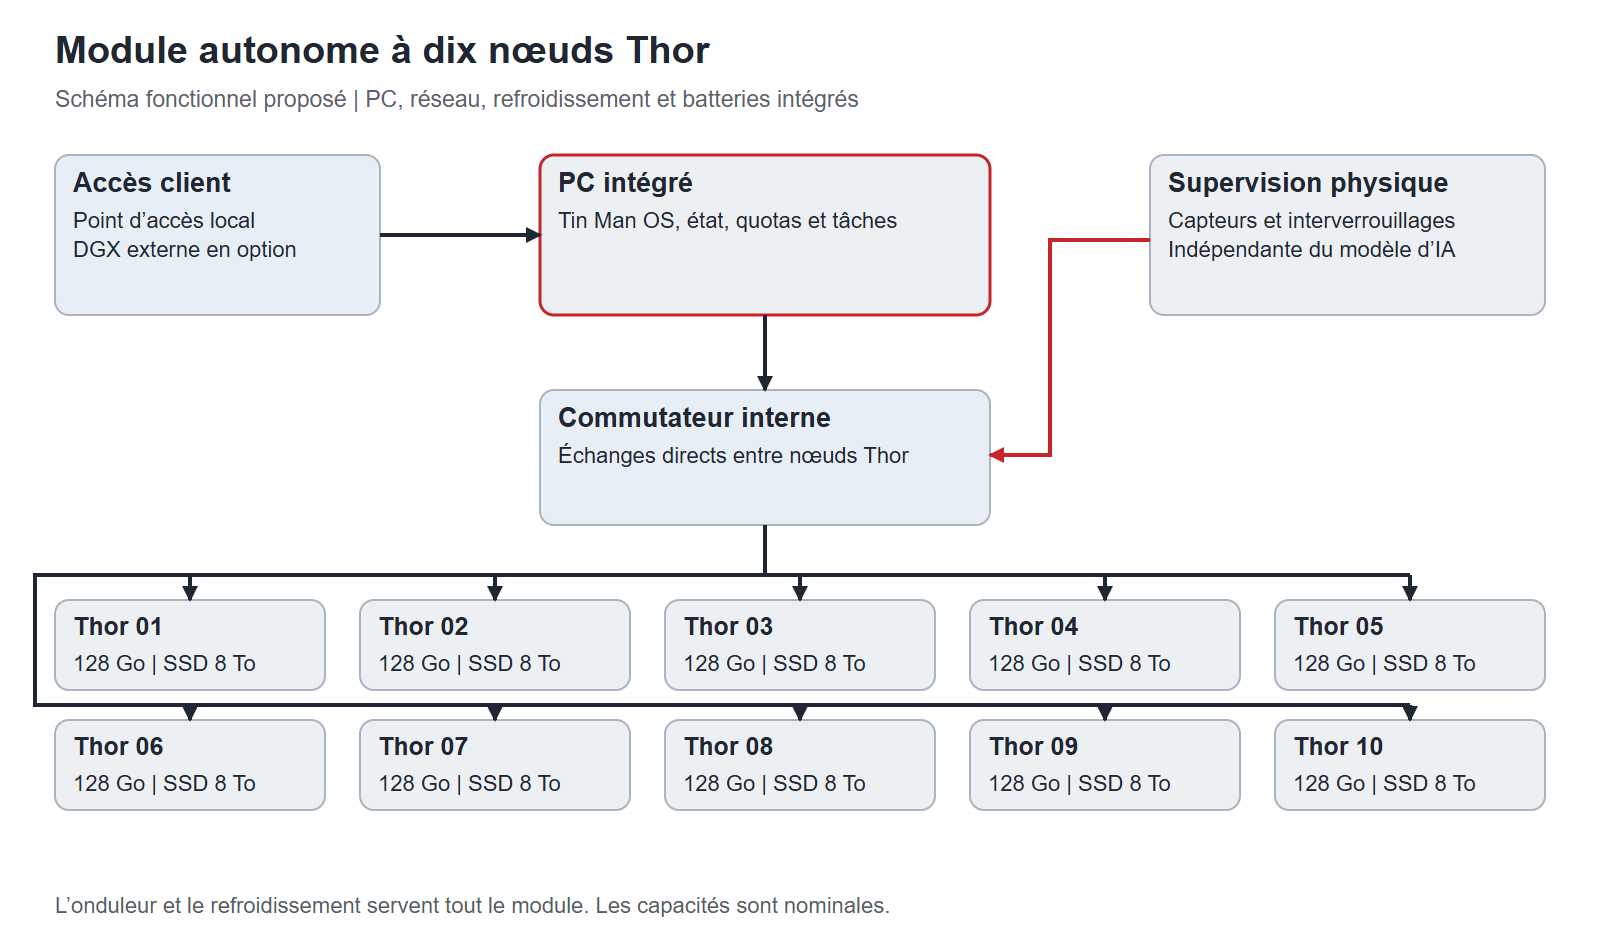
Dix nœuds représentent 1 280 Go nominaux de mémoire et 80 To de stockage SSD brut ; quarante nœuds, 5 120 Go et 320 To. Ces ressources sont distribuées. Chaque nœud doit accueillir sa part de poids, de cache, de données de travail et de services : leur somme ne devient pas automatiquement la mémoire d’un seul GPU. Le logiciel détermine quelle part de cette capacité installée peut produire un travail utile.
Deux façons de travailler avec les LLM
Le premier mode, des spécialistes coordonnés, confie des tâches différentes à des modèles complets : l’un peut lire des documents techniques, un autre assister le développement logiciel, un troisième préparer des données pour une application métier. Le coordinateur organise les activités, conserve leurs résultats et construit une réponse dont la provenance peut être vérifiée. Les spécialistes peuvent utiliser des versions de modèle différentes ou des adaptateurs compatibles sur un même modèle de base.
Imaginons une demande d’ingénierie : interpréter une exigence, retrouver les documents pertinents, préparer les entrées d’un solveur autorisé et produire un rapport. Le LLM aide à relier ces étapes. Le calcul numérique conserve sa méthode de vérification, les outils gardent leurs permissions et la révision humaine reste identifiable. Le travail peut ainsi se spécialiser sans donner à un modèle le pouvoir d’exécuter n’importe quelle action.
Le second mode, un modèle unique distribué, répond à un autre besoin : exécuter un modèle qui dépasse le budget d’un seul nœud. Le modèle conserve une identité unique — poids, tokenizer, précision et transformations — tandis que des parties de son calcul sont réparties entre plusieurs Thor. Envoyer la même question à dix assistants ne suffit pas : il faut réellement distribuer le graphe d’exécution.
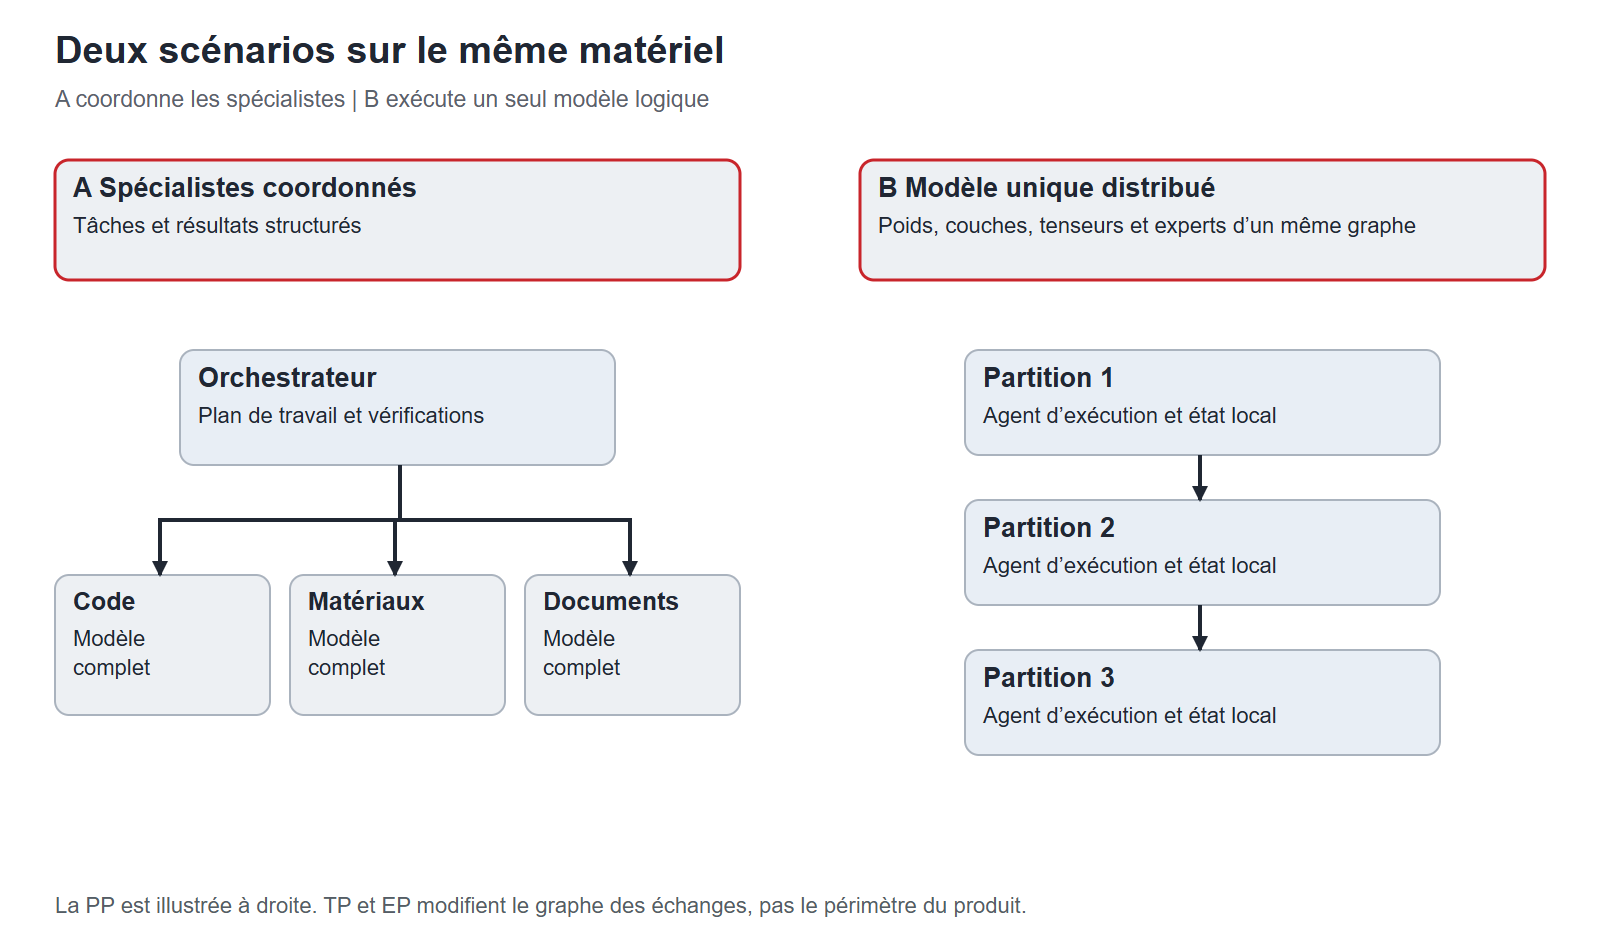
Le parallélisme de pipeline attribue des groupes de couches à des nœuds successifs. Le parallélisme de tenseurs répartit le calcul à l’intérieur d’une couche. Le parallélisme d’experts distribue les experts d’un modèle Mixture of Experts. Le choix dépend du modèle, du moteur d’inférence et du réseau effectivement pris en charge. Ajouter des nœuds peut accroître la capacité ou le nombre de requêtes servies, alors que les communications continuent de limiter la latence d’une réponse individuelle.
Cette distinction ouvre une perspective intéressante : employer la même infrastructure pour un ensemble de services spécialisés ou pour expérimenter des modèles plus grands. Le meilleur plan pourra même utiliser moins de nœuds que ceux disponibles, si cela offre un meilleur équilibre entre qualité, délais et énergie.
Le parcours d’un modèle : du catalogue au service
La gestion prévue commence par une fiche du modèle : origine, révision, licence, architecture, tokenizer, format des poids et contexte pris en charge. Le modèle doit convenir à la tâche, être compatible avec le moteur choisi et être utilisable selon sa licence. Ces trois vérifications déterminent son entrée dans le parcours opérationnel.
Le préparateur produit des paquets ou des partitions avec manifestes et empreintes d’intégrité. Le planificateur évalue la mémoire de chaque nœud, le cache des conversations, les sessions simultanées, les opérateurs disponibles, le réseau et le budget énergétique. Un plan qui dépasse les limites est écarté avec une raison compréhensible. Lorsqu’une quantification est retenue, elle doit préciser le changement de représentation des poids et la comparaison de qualité effectuée.
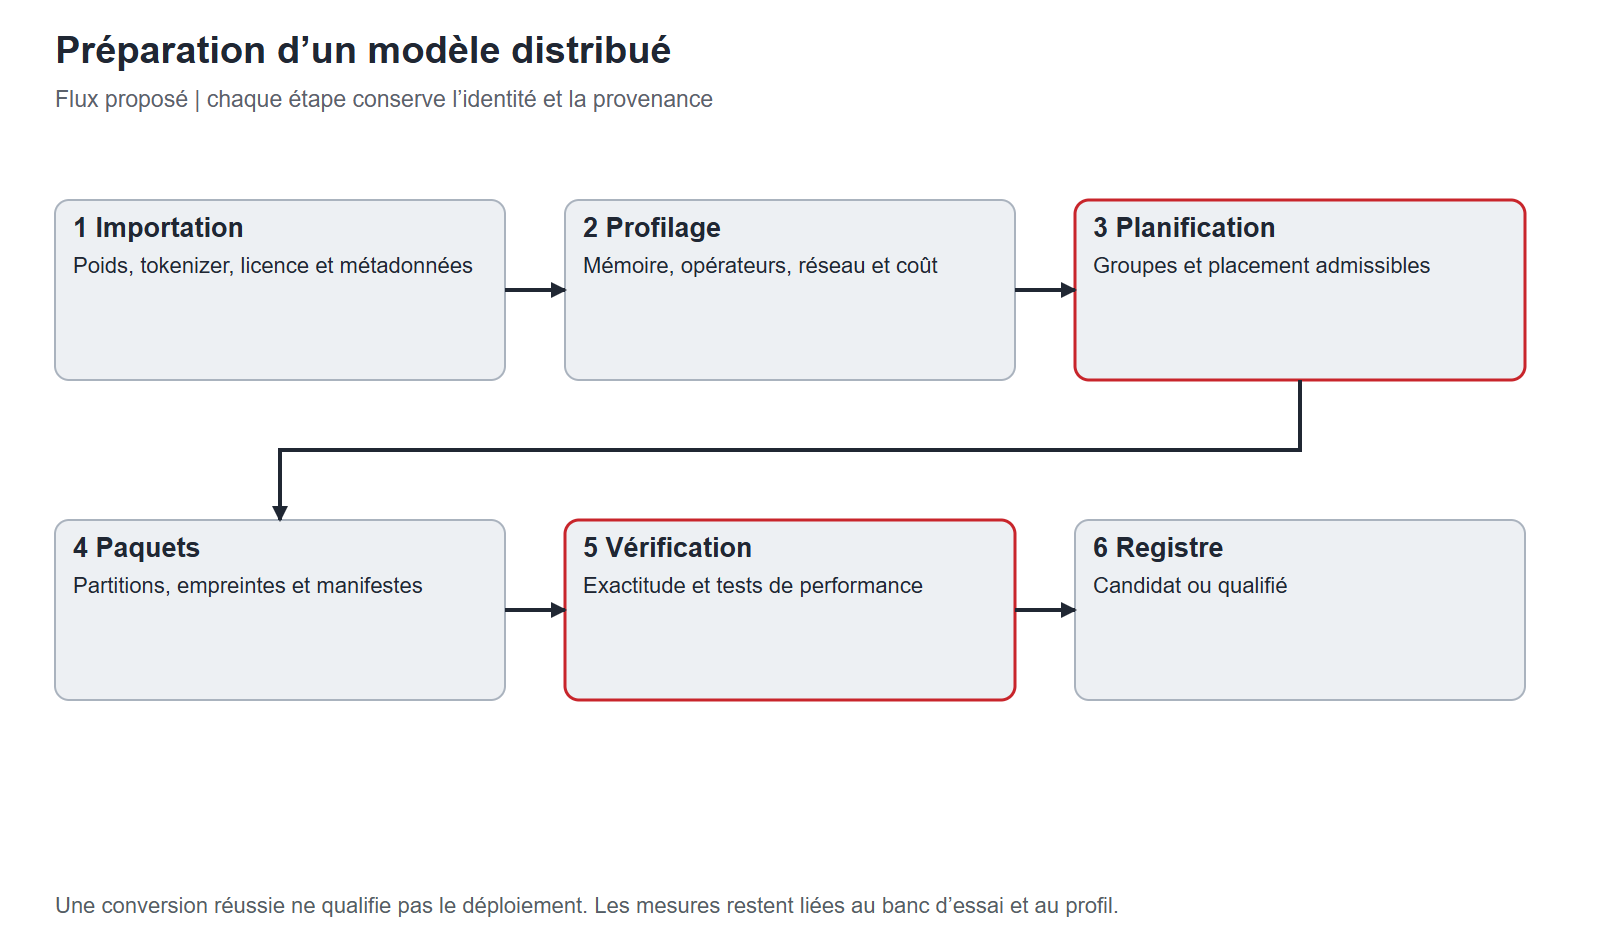
Dans l’architecture logicielle, Tin Man OS Foundry constitue le laboratoire permettant de configurer, simuler et comparer les plans. Le contrôleur du PC intégré admet les travaux et réserve les ressources ; les processus d’exécution sur les Thor effectuent le calcul ; la passerelle expose le service aux applications. Les tenseurs suivent le chemin de données du moteur sans traverser la console de développement. Cette séparation permet de faire évoluer laboratoire et exécution en conservant des responsabilités claires.
La souveraineté, c’est pouvoir fonctionner et reprendre
Une implantation locale peut réduire le transfert de données sensibles vers des services externes et permet de concevoir accès, conservation et mises à jour selon les besoins de l’entreprise. Pour rendre cette autonomie concrète, le dossier exige des modèles et licences disponibles localement, des sauvegardes restaurables, une séparation entre contextes autorisés et des procédures éprouvées sans accès Internet.
La reproductibilité constitue un bénéfice potentiel : associer un résultat à une version du modèle, à des outils et données identifiés, à un plan d’exécution. Un autre est la liberté d’affecter des ressources à des charges confidentielles ou spécialisées. La comparaison économique avec des services externes devra porter sur les usages réels et inclure matériel, énergie, maintenance et assistance. Le projet conserve aussi des dépendances envers la chaîne d’approvisionnement et les logiciels utilisés.
La continuité se joue dans les détails opérationnels. Si une requête expire, le contrôleur doit établir ce qui s’est passé avant de la répéter. Si un spécialiste devient indisponible, une réplique qualifiée peut prendre le relais. Si une partition indispensable d’un modèle distribué est perdue, ce modèle s’arrête et nécessite la reprise prévue. Rendre ces états explicites participe à la qualité du service.
L’énergie et le refroidissement font partie du produit
L’enveloppe initiale de conception est de 2,5 à 3,0 kW aux charges par module, à vérifier sur la nomenclature finale. Le prélèvement sur le réseau comprend en plus les pertes de l’onduleur et la recharge des batteries. L’autonomie dépendra de la configuration et des courbes du fabricant : le dossier n’atteste pas des heures de service déjà mesurées.
La protection envisagée couvre également pompes, réseau et contrôle. En cas de coupure, le système devra réduire l’admission de nouveaux travaux, terminer ou laisser s’achever les activités admises, puis s’arrêter de manière ordonnée. Le refroidissement liquide transfère la chaleur vers l’échangeur et l’environnement ; le local technique doit toujours être correctement dimensionné. Les dispositifs physiques de sécurité restent indépendants des modèles linguistiques et de leur disponibilité.
Les applications donnent un sens à la capacité
Pour une entreprise, la valeur se manifeste dans ses processus : consultation du patrimoine documentaire, assistance aux développeurs, préparation d’entrées techniques, comparaison d’options et production de rapports traçables. Le projet envisage des intégrations avec Alchemi et AEROMAG au moyen de services et d’artefacts versionnés. Les possibilités comprennent des spécialistes métier et une aide à la recherche, tout en préservant la validation scientifique distincte des solveurs, simulations et résultats expérimentaux.
Le programme privilégie l’inférence et des adaptations ciblées. Un éventuel modèle Reinventy plus spécialisé demandera ses propres jeux de données, licences et évaluations ; le préentraînement d’un modèle de pointe nécessite un plan séparé. Cette progression permet de commencer par des tâches utiles et mesurables, en construisant une connaissance du comportement du système avant d’élargir l’ambition.
Du banc à deux Thor au système opérationnel
La réalisation progresse par les preuves : deux Thor pour vérifier la justesse et le coût de la distribution, quatre pour comparer les topologies, dix pour intégrer le module, puis plusieurs modules pour mesurer le bénéfice de la fédération. Le dossier demande des comparaisons sur un même modèle et profil, avec mesure du délai au premier token, de la régularité de génération, de la qualité, de la concurrence, de l’énergie et de la reprise après incident.
Le potentiel de Sovereign Edge AI se situe à la rencontre de ces disciplines. Un module pouvant être approvisionné et entretenu, des modèles identifiables, des travaux récupérables et des résultats vérifiables peuvent fournir à l’entreprise une base pour ses propres services. L’objectif est une IA que l’organisation sait utiliser, gouverner et faire évoluer : une capacité qui entre dans son patrimoine opérationnel.
Sources et images
Base éditoriale : documents Reinventy SEA HW 001 et SEA SW 001, révision 1.0, 20 octobre 2026, utilisés pour cet éditorial. Le concept du cabinet provient des DOCX originaux. Les schémas ont été redessinés à partir du code source avec des légendes françaises ; ils représentent des architectures proposées.
Références techniques de contrôle : NVIDIA Jetson Thor — caractéristiques du composant — https://www.nvidia.com/en-us/autonomous-machines/embedded-systems/jetson-thor/ et vLLM — parallélisme et montée en charge — https://docs.vllm.ai/en/stable/serving/parallelism_scaling/ , consultés le 25 octobre 2026. Ces sources décrivent des composants et des méthodes ; la qualification du système Reinventy suivra les essais prévus au dossier.