L’AI diventa infrastruttura d’impresa
· Di Antonio Sedino, CTRO · Reinventy Solutions Corp.
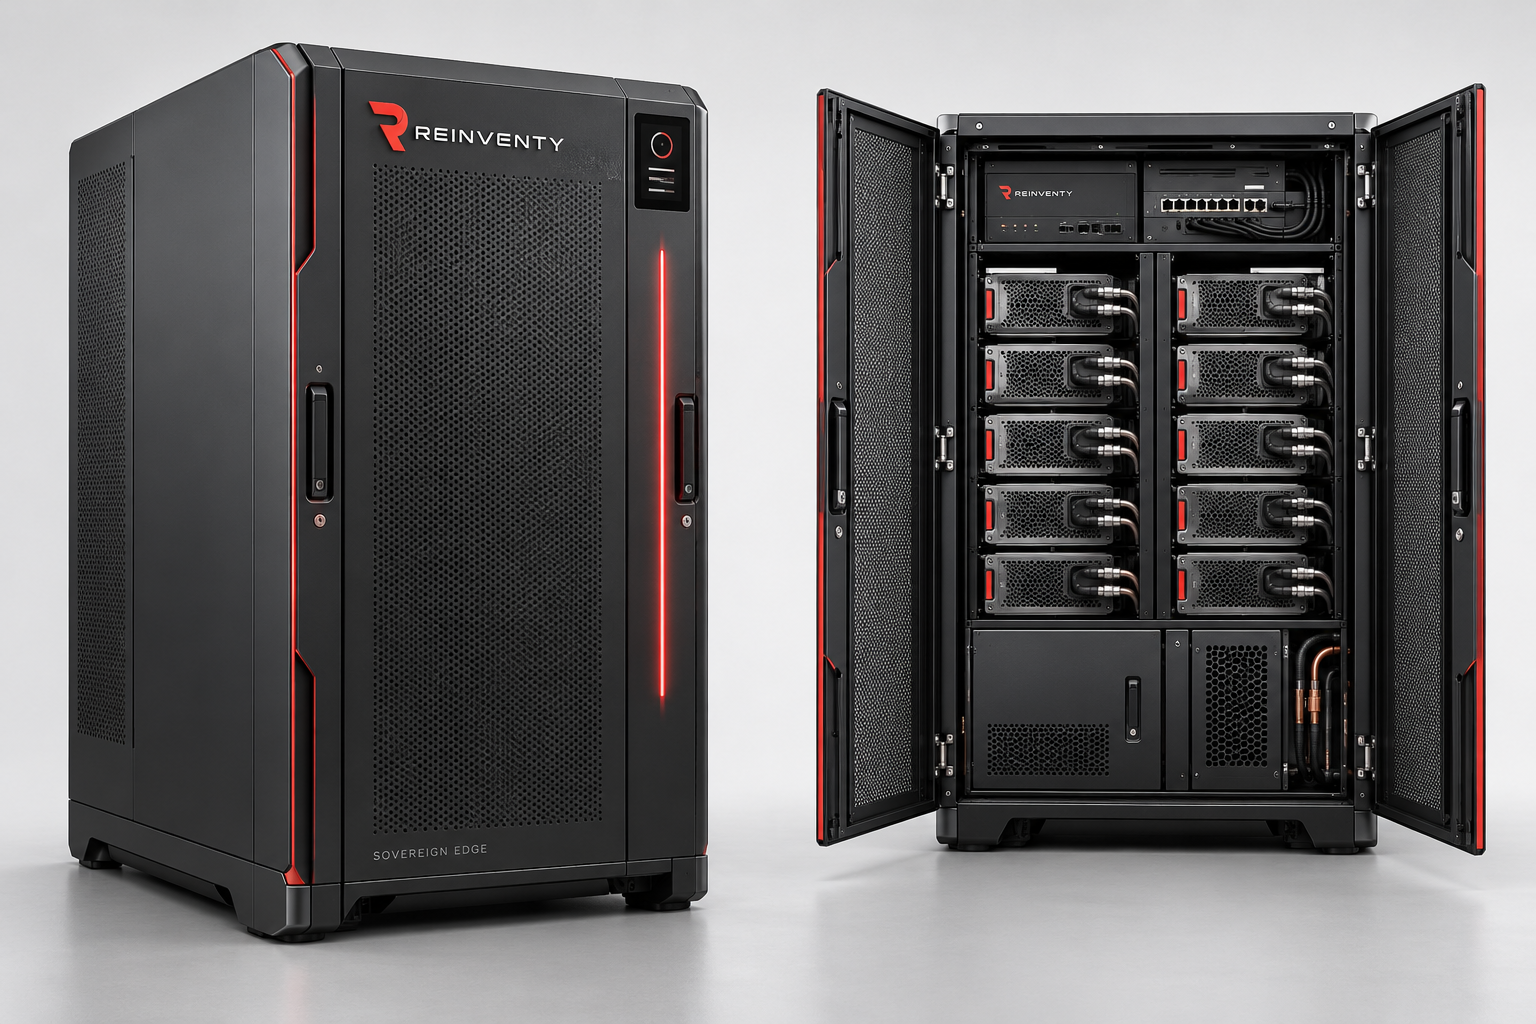
Dieci Thor per modulo, un’architettura espandibile e Tin Man OS per governare modelli, risorse e continuità. Il progetto Sovereign Edge AI porta una domanda concreta al centro del dibattito: che cosa serve perché l’intelligenza artificiale diventi una capacità che l’impresa sa gestire?
Dentro il progetto del micro data center sovrano Reinventy
Una parte crescente del valore di un’impresa vive nei suoi documenti, nelle procedure, nel codice e nell’esperienza delle persone. L’intelligenza artificiale può rendere questo patrimonio più accessibile: aiutare a leggere una specifica, collegare informazioni disperse, preparare una simulazione o affiancare un progettista. Per farlo bene, però, occorre dare all’AI un posto preciso nell’organizzazione: stabilire dove lavora, con quali dati, con quali strumenti e sotto quale responsabilità.
Il progetto Reinventy Sovereign Edge AI nasce da questa esigenza. Propone un micro data center modulare che riunisce calcolo, rete, gestione, alimentazione protetta e raffreddamento, con un software pensato per trasformare risorse fisiche in servizi utilizzabili. È il passaggio da una disponibilità occasionale di potenza a una capacità operativa progettata.
Lo stato del progetto. Questo editoriale presenta le specifiche hardware SEA HW 001 e software SEA SW 001, revisione 1.0 del 20 ottobre 2026. Definiscono architettura, operazioni e percorso di realizzazione; distinta definitiva, disegni costruttivi, nuove componenti software e qualificazione fisica restano da completare. Le immagini illustrano il progetto, non attestano un sistema già costruito o prestazioni misurate.
Un modulo completo, con dieci nodi di calcolo
L’unità di riferimento prevede dieci NVIDIA Jetson T5000, chiamati Thor, ciascuno con 128 GB nominali di memoria unificata e uno storage SSD locale da 8 TB nella configurazione candidata. Un PC integrato coordina il modulo; la rete interna collega i nodi; raffreddamento a liquido, UPS APC online con batterie e supervisione fisica indipendente completano l’insieme.
La disposizione proposta rende leggibile l’architettura: controllo e rete nella zona superiore, dieci slitte compute al centro, UPS e batterie nella parte inferiore, circuito termico in un vano tecnico dedicato. Questa scelta dà al progetto anche una dimensione di manutenzione: identificare un nodo, raggiungere i collegamenti e sostituire una parte devono essere operazioni pianificate.
Il sistema è concepito per crescere da uno a quattro moduli, quindi da 10 a 40 Thor. Una DGX esterna può ampliare le possibilità o offrire una piattaforma di confronto; il funzionamento locale del modulo base deve essere possibile senza di essa e senza un PC cliente sempre collegato.
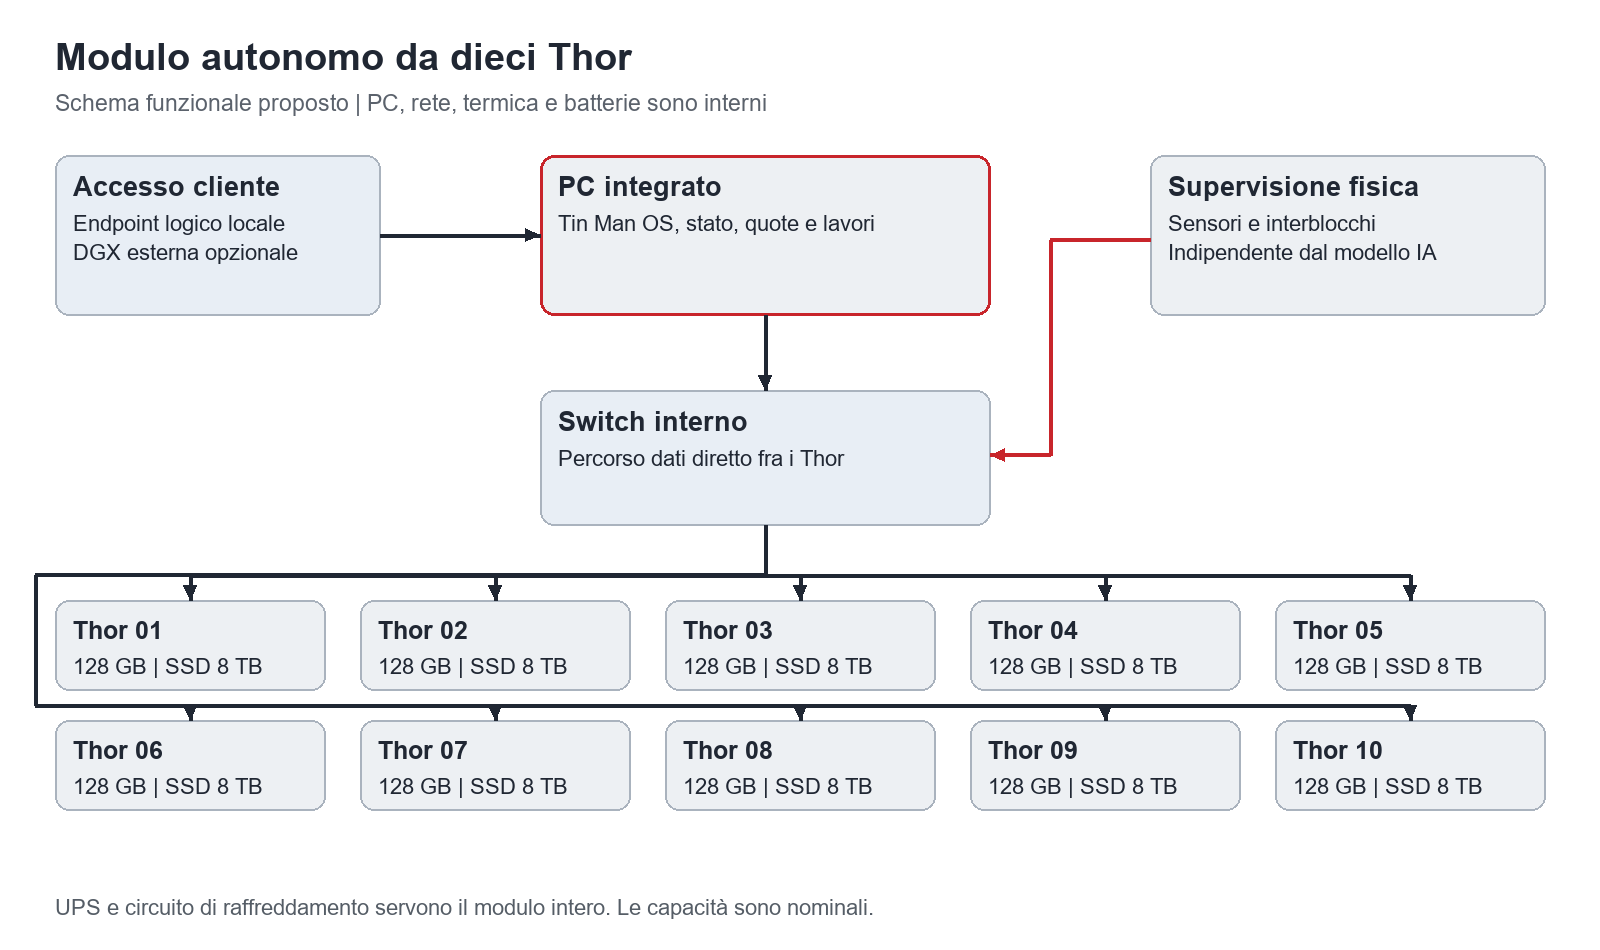
Dieci nodi portano a 1.280 GB nominali di memoria e 80 TB di SSD grezzi; quaranta nodi a 5.120 GB e 320 TB. Sono risorse distribuite. Ogni nodo deve ospitare la propria quota di pesi, cache, dati di lavoro e servizi: la somma non diventa automaticamente la memoria di una singola GPU. È proprio qui che il software decide quanto della capacità installata può diventare lavoro utile.
Due modi di lavorare con gli LLM
La prima modalità, specialisti coordinati, assegna compiti diversi a modelli completi: uno può leggere documenti tecnici, uno assistere sul codice, un altro preparare dati per un’applicazione di dominio. Il coordinatore organizza le attività, ne conserva i risultati e costruisce una risposta con una provenienza verificabile. Gli specialisti possono usare checkpoint diversi o adattatori compatibili sullo stesso modello base.
Immaginiamo una richiesta di ingegneria: interpretare un requisito, cercare documenti pertinenti, predisporre gli input per un solver autorizzato e produrre un rapporto. L’LLM aiuta a collegare questi passaggi. Il calcolo numerico conserva il suo metodo di verifica, gli strumenti mantengono i propri permessi e la revisione umana resta riconoscibile. Si può così specializzare il lavoro senza attribuire a un modello l’autorità di eseguire qualsiasi azione.
La seconda modalità, un unico modello distribuito, affronta un’esigenza diversa: eseguire un modello che supera il budget di un solo nodo. Il modello mantiene una sola identità — pesi, tokenizer, precisione e trasformazioni — mentre parti del suo calcolo vengono collocate su più Thor. Non basta inviare la stessa domanda a dieci assistenti: occorre distribuire realmente il grafo di esecuzione.
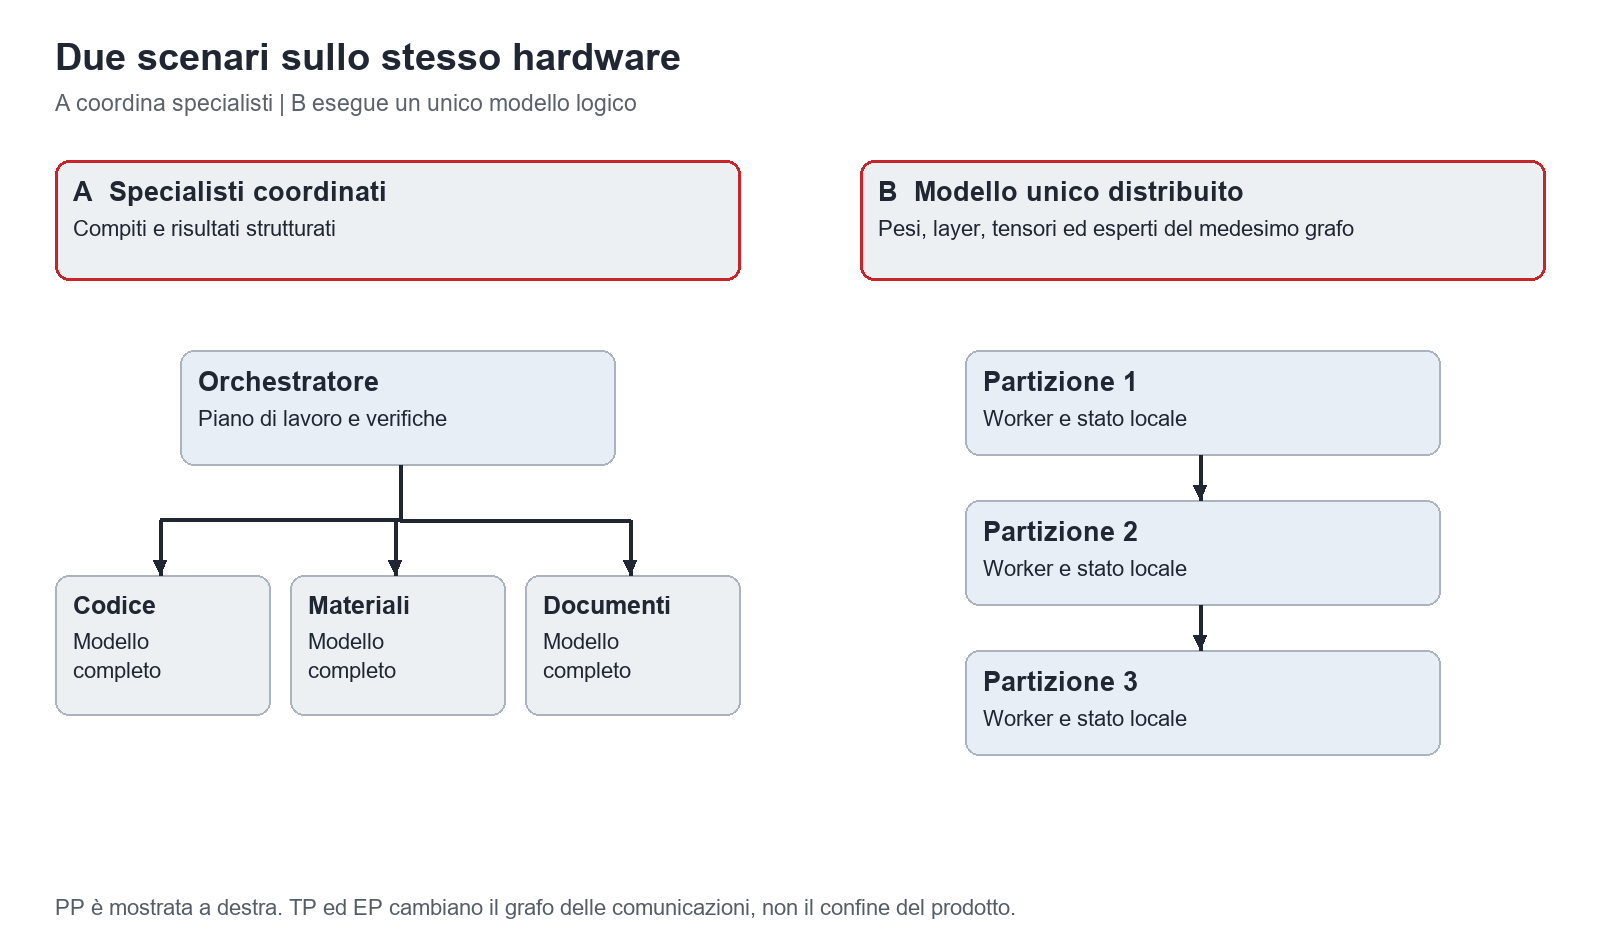
Il pipeline parallelism assegna gruppi di strati a nodi successivi. Il tensor parallelism divide il calcolo all’interno di uno strato. L’expert parallelism distribuisce gli esperti di un modello Mixture of Experts. La scelta dipende dal modello, dal runtime e dalla rete effettivamente supportati. Aggiungere nodi può aumentare la capacità o le richieste servite, mentre la latenza di una singola risposta può restare limitata dalle comunicazioni.
Questa distinzione apre una possibilità interessante: impiegare la stessa infrastruttura per un insieme di servizi specializzati oppure per sperimentare modelli più grandi. Il piano migliore potrà anche usare meno nodi di quelli disponibili, se offre un equilibrio più favorevole fra qualità, tempi ed energia.
Il percorso di un modello: dal catalogo al servizio
La gestione prevista parte da una scheda del modello: origine, revisione, licenza, architettura, tokenizer, formato dei pesi e contesto supportato. Un modello deve essere adatto al compito, compatibile con il backend e utilizzabile alle condizioni della sua licenza. Queste tre verifiche determinano l’ingresso nel percorso operativo.
Il preparatore produce pacchetti o shard con manifest e impronte di integrità. Il planner valuta memoria per nodo, cache delle conversazioni, sessioni concorrenti, operatori disponibili, rete e budget energetico. Un piano che eccede i limiti viene escluso con una ragione leggibile. La quantizzazione, quando adottata, deve dichiarare come cambia la rappresentazione dei pesi e quale confronto di qualità è stato eseguito.
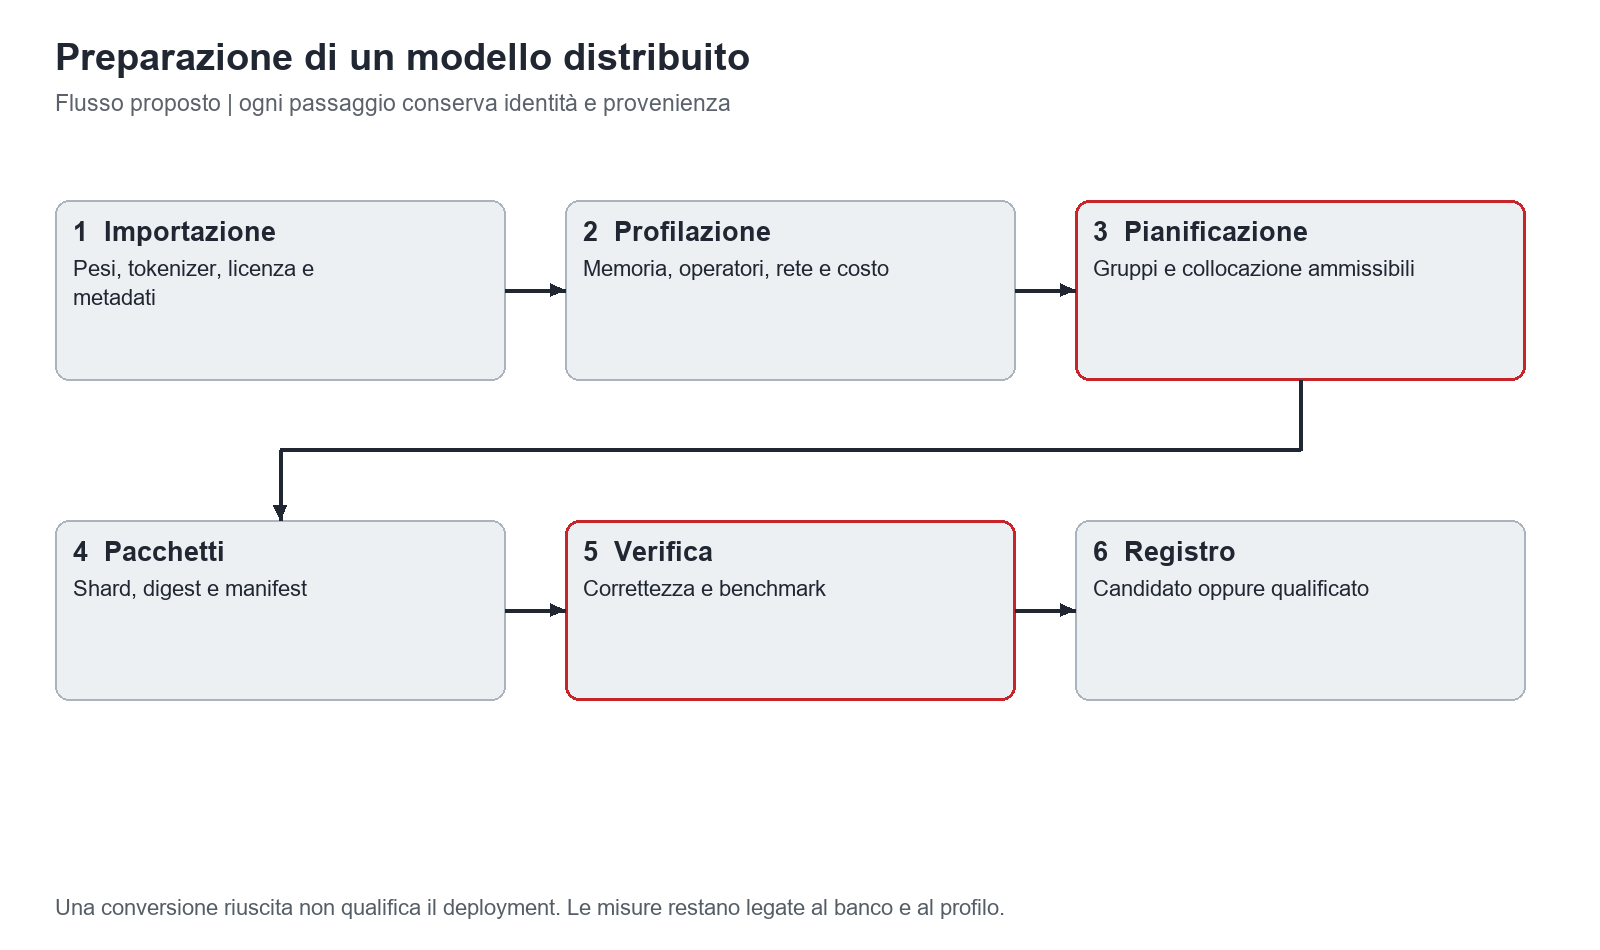
Nel disegno software, Tin Man OS Foundry è il laboratorio in cui configurare, simulare e confrontare i piani. Il controller sul PC integrato ammette i lavori e prenota le risorse; i worker sui Thor eseguono il calcolo; il gateway espone il servizio alle applicazioni. I tensori seguono il percorso del runtime, senza transitare nella console di sviluppo. Questa separazione permette di evolvere il laboratorio e l’esecuzione mantenendo responsabilità chiare.
Sovranità significa poter operare e ripartire
La collocazione locale può ridurre il trasferimento di dati sensibili verso servizi esterni e consente di progettare accessi, conservazione e aggiornamenti secondo le esigenze dell’impresa. Per rendere concreta questa autonomia, il dossier richiede disponibilità locale di modelli e licenze, backup ripristinabili, isolamento fra contesti autorizzati e procedure provate anche senza Internet.
Un vantaggio potenziale è la riproducibilità: poter associare un risultato a una versione del modello, a strumenti e dati identificati, a un piano di esecuzione. Un altro è la libertà di destinare risorse a carichi riservati o specialistici. Il confronto economico con servizi esterni andrà svolto sul carico reale, includendo hardware, energia, manutenzione e supporto. Il progetto mantiene inoltre dipendenze dalla filiera dei componenti e dal software utilizzato.
La continuità si gioca anche nei dettagli operativi. Se una richiesta va in timeout, il controller deve verificare che cosa sia accaduto prima di ripeterla. Se uno specialista manca, può essere disponibile una replica qualificata. Se viene perso uno shard necessario di un modello distribuito, quel modello si ferma e richiede il recupero previsto. Rendere espliciti questi stati è parte della qualità del servizio.
Energia e raffreddamento fanno parte del prodotto
Il budget iniziale di progetto è 2,5–3,0 kW ai carichi per modulo, da verificare sulla distinta finale. A questo si aggiungono, sul prelievo dalla rete, perdite UPS e ricarica delle batterie. L’autonomia dipenderà dalla configurazione e dalle curve del produttore: il dossier non attesta ore di servizio già misurate.
La protezione prevista coinvolge anche pompe, rete e controllo. In caso di mancanza rete, il sistema dovrà ridurre l’ammissione di nuovi lavori, completare o drenare le attività ammesse e arrestarsi in modo ordinato. Il raffreddamento a liquido trasferisce il calore allo scambiatore e all’ambiente; il locale tecnico deve comunque essere dimensionato. Gli interblocchi fisici restano indipendenti dai modelli linguistici e dalla loro disponibilità.
Le applicazioni che danno senso alla capacità
Per un’impresa, il valore si esprime nei processi: consultazione del patrimonio documentale, assistenza agli sviluppatori, preparazione di input tecnici, confronto di alternative e produzione di rapporti tracciabili. Il progetto contempla integrazioni con Alchemi e AEROMAG attraverso servizi e artefatti versionati. Le opportunità includono specialisti di dominio e supporto alla ricerca, mantenendo separata la validazione scientifica di solver, simulazioni e risultati sperimentali.
Il programma privilegia inferenza e adattamenti selezionati. Un eventuale modello Reinventy più specializzato richiederà dataset, licenze e valutazioni proprie; il pretraining di un modello di frontiera necessita di un piano distinto. Questa progressione consente di partire da compiti utili e misurabili, costruendo conoscenza sul comportamento del sistema prima di ampliare l’ambizione.
Dal banco a due Thor al sistema operativo
Il percorso di realizzazione cresce per evidenze: due Thor per verificare correttezza e costi della distribuzione, quattro per confrontare le topologie, dieci per integrare il modulo, poi più moduli per misurare il beneficio della federazione. Il dossier chiede confronti sullo stesso modello e profilo, misurando tempo al primo token, regolarità della generazione, qualità, concorrenza, energia e recupero dai guasti.
La potenzialità di Sovereign Edge AI sta nell’incontro fra queste discipline. Un modulo acquistabile e manutenibile, modelli identificabili, lavori recuperabili e risultati verificabili possono dare all’impresa una base su cui costruire servizi propri. Il traguardo è un’AI che l’organizzazione sappia usare, governare e far evolvere: una capacità che entra nel suo patrimonio operativo.
Fonti e immagini
Base editoriale: documenti Reinventy SEA HW 001 e SEA SW 001, revisione 1.0, 20 ottobre 2026, utilizzati per questo editoriale. Le quattro immagini sono estratte dai DOCX originali. Il concept del cabinet è un’illustrazione di progetto; gli schemi rappresentano architetture proposte.
Riferimenti tecnici di riscontro: NVIDIA Jetson Thor — specifiche del componente — https://www.nvidia.com/en-us/autonomous-machines/embedded-systems/jetson-thor/ e vLLM — parallelismo e scaling — https://docs.vllm.ai/en/stable/serving/parallelism_scaling/ , consultati il 25 ottobre 2026. Queste fonti descrivono componenti e metodi; la qualificazione del sistema Reinventy seguirà le prove previste nel dossier.